안녕하세요~ 푸르니입니다^___^
오늘은 제가 대학원에서 수강한 딥러닝 기초 강의를 기반으로
Image Classification 에 대해 리뷰할거에요!
첫수업 내용이라서 기본적인 내용과 함께
인공지능의 역사 (?)를 가볍게 알려주셨어요!
그럼 강의 내용을 가볍게 적어볼게요~
NN과 DL은 같다!!
사실 저는 NN과 DL이 다른 개념이라고 생각했는데 같은 것이더라구요?!
2000년대에는 인공지능의 암흑기라서
NN으로 연구를 할 경우 연구비 지원도 잘 안나올정도였대요 ㅠㅠ
인공지능 붐인 현재와 너무 다르죠?
그래서 딥러닝으로 이름을 바꿔 연구하여
지금 우리가 쓰는 DL이라는 단어가 알려진거래요!
인공지능 암흑기임에도 연구를 계속 이어가신
3분이 계신데 바로
Hinton, Legin, Bengin이라는 분이에요!
미국에서 캐다다로까지 가셨다고 합니다!!
인공지능에 대한 열정이 대단하죠??
이렇게 해서 2010년대에 다시 인공지능이 살아났고
현재까지 그 인기가 이어지고 있어요!
2010년대부터 인공지능의 흐름
2012 - Image Classification
2015 - Detection
2018 - NLP
2020 - Andio
신약개발, 바이오 분야 등 다양하게 인공지능이 활용되고 있고
최근에는 새로운 분자구조 발견으로
노벨 화학상까지 받게 될만큼
인공지능의 쓰임은 넓어졌어요!!
Image Classification
이미지 분류는 시각적인 작업이에요!
인풋으로 이미지가 주어지면 여러개의 카테고리 중에서
인풋 이미지가 속하는 카테고리를
아웃풋으로 출력해요!
(요즘의 심화된 딥러닝으로는
주어진 카테고리가 없어도 아웃풋이 나오는 것도 있대요!)
컴퓨터는 이미지를 볼때
[0,255] 범위 숫자로 이루어진 배열로 인식한대요
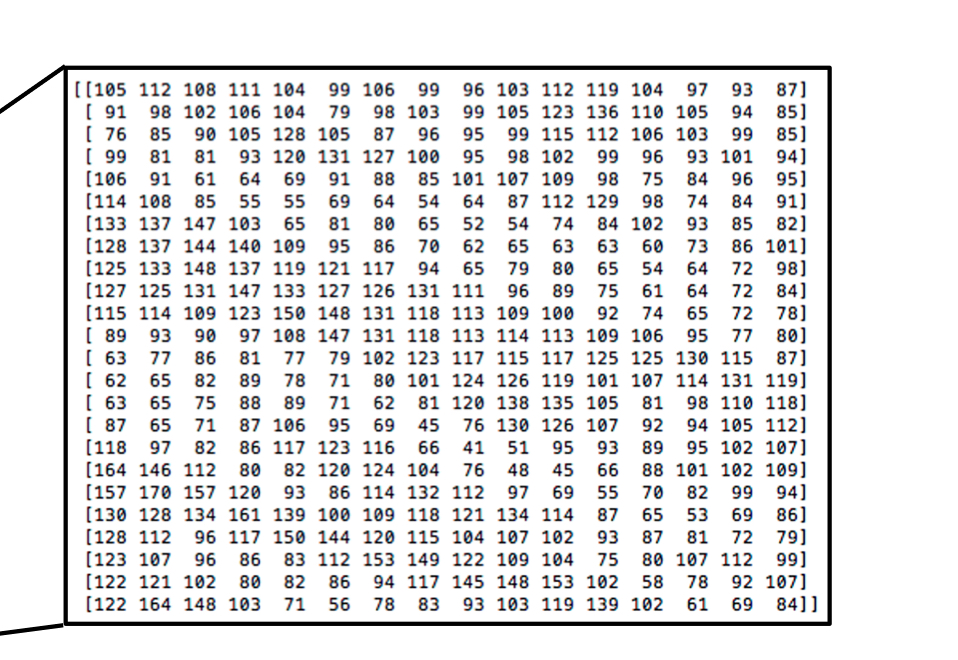
위의 사진처럼 숫자로 인식한답니다!
그래서 문제점이 카메라 각도가 변경될 때마다
이 숫자들이 맥락없이 변경된다는 것이에요!
또한 같은 분류의 데이터라도 매우 다양한 비전이 나올 수 있고요!
조명이나 배경, 피사체의 자세, 가려짐 정도에 따라서도 많은 영향을 받아요
Object Detection
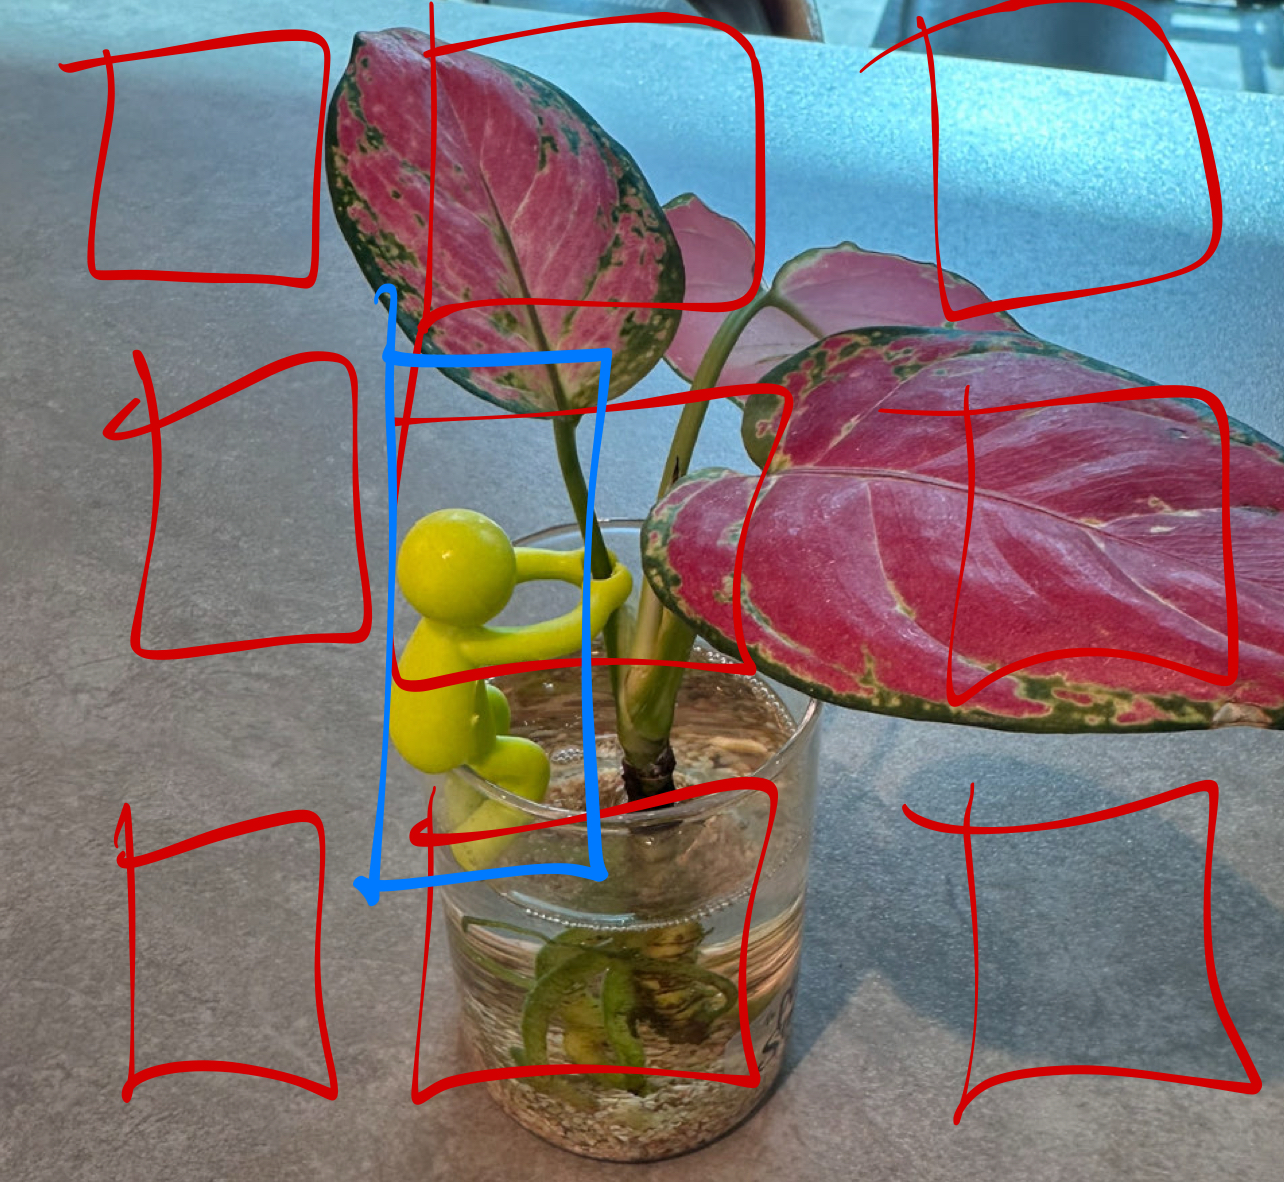
위 사진에서 빨간색 사각형 여러개로 표시된 것 보이시죠?
이것이 바로 Image Proposal이에요!
여러개의 Image Proposal 중 파란색으로 표시된 쪽의 것들이
Resign Proposal이 되어서 "피규어"로 Detection을 한답니다!
Image Captioning
이미지를 설명해주는 것이에요!
어떤 이미지와 단어가 주어졌을때
그 다음에 올 단어를 추측하는 것입니다!
Auto Regression Rate라고 해요!
알고리즘을 하드코딩하는 명백한 방법은 없다!
단순히 숫자 리스트를 소팅하는 것과는 달리
고양이를 분류하거나 다른 클래스를 분류하는 알고리즘은
하드코딩으로 불가능해요!
그래서 나온것이 바로!
Data-Driven Approach
알고있는 데이터를 이용해서
모르는 것을 할 수 있게 하는 것이에요!
바로 머신러닝이죠!
머신러닝의 3단계
1. 이미지, 라벨로 구성된 Dataset 모으기
2. 분류 학습을 위한 머신러닝 사용하기
3. 테스트 이미지들을 대상으로 평가하기
1,3 단계가 중요하다고 합니다!
주로 2단계인 학습을 중요하다고 생각하는데
요즘은 많은 학습 방법이 나와서
1,3단계가 중요하대요!!
MNIST
(손글씨) - 현재는 Toy DataSet이라고 부름 (복잡한 실제 세계에서는 보장안됨, 검증 필요)
분류 카테고리 수 : 10개
28 * 28 grayscale Images
50K training images
10K test images
CIFAR10
분류 카테고리 수 : 10개
50K training images (5K per class)
10K testing images (1k per class)
32 * 32 RGB images
CIFAR100
분류 카테고리 수 : 100개 (20개의 SuperClass가 상위에 존재 - 5 분류씩 묶임)
50K training images (500 per class)
10K testing images (100 per class)
32 * 32 RGB images
ImageNet
분류 카테고리 수 : 1000개
~1.3M training images (클래스당 ~1.3K개 데이터 존재)
50K validation images
100K test images
퍼포먼스 단계(Performance metric) : Top 5 accuracy (각 이미지 당 5개 분류 선택 알고리즘 : 5개 중 1개는 정답)
MIT Places
분류 카테고리 수 : 365개
~8M training images
18.25 Val images (클래스당 50개)
328.5K test images (클래스당 900개)
이미지 크기 다양함 (주로 256 * 256)
Omniglot
데이터 수가 적을때 DL을 하기위한 데이터셋
분류 카테고리 수 : 1623개
각 카테고리당 20개의 이미지
Few shot learning
Nearest Neighbor
모든 데이터와 라벨을 저장 후 가장 비슷한 학습 이미지를 추측해요!
(유사도 측정)
L1 Distance
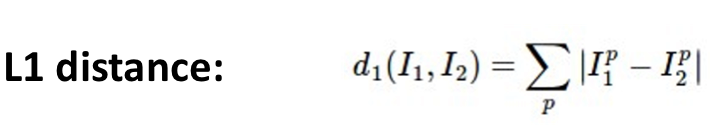
L1 distance는 값 차이의 절댓값의 합을 계산해요!
이 거리가 가장 짧은걸 선택하는 것인데
좋진 않다고 합니다!
왜냐하면 평가가 오래걸리기 때문이죠!
(트레이닝 시간복잡도 : O(1),
테스트 시간복잡도 : O(N))
요즘 환경 문제로전기를 많이 쓰는 트레이닝 단계도 빨라야한다고 하긴하네요!
(트레이닝시 GPU를 사용하는데
GPU가 전기를 많이 먹기때문)
용어정리
Training = Learning
Example = Sample = Image
그럼 오늘도 고생많으셨습니다!
구독 추천 한번씩 부탁드려용!!
'AI > 딥러닝기초' 카테고리의 다른 글
| 딥러닝 Loss Function (0) | 2025.03.22 |
|---|---|
| 딥러닝 Linear Classifiers (0) | 2025.03.22 |
| 딥러닝 Nearest Neighbor (0) | 2025.03.15 |